Podcast (English)
Podcast(中文)
Video Overview
簡報圖卡
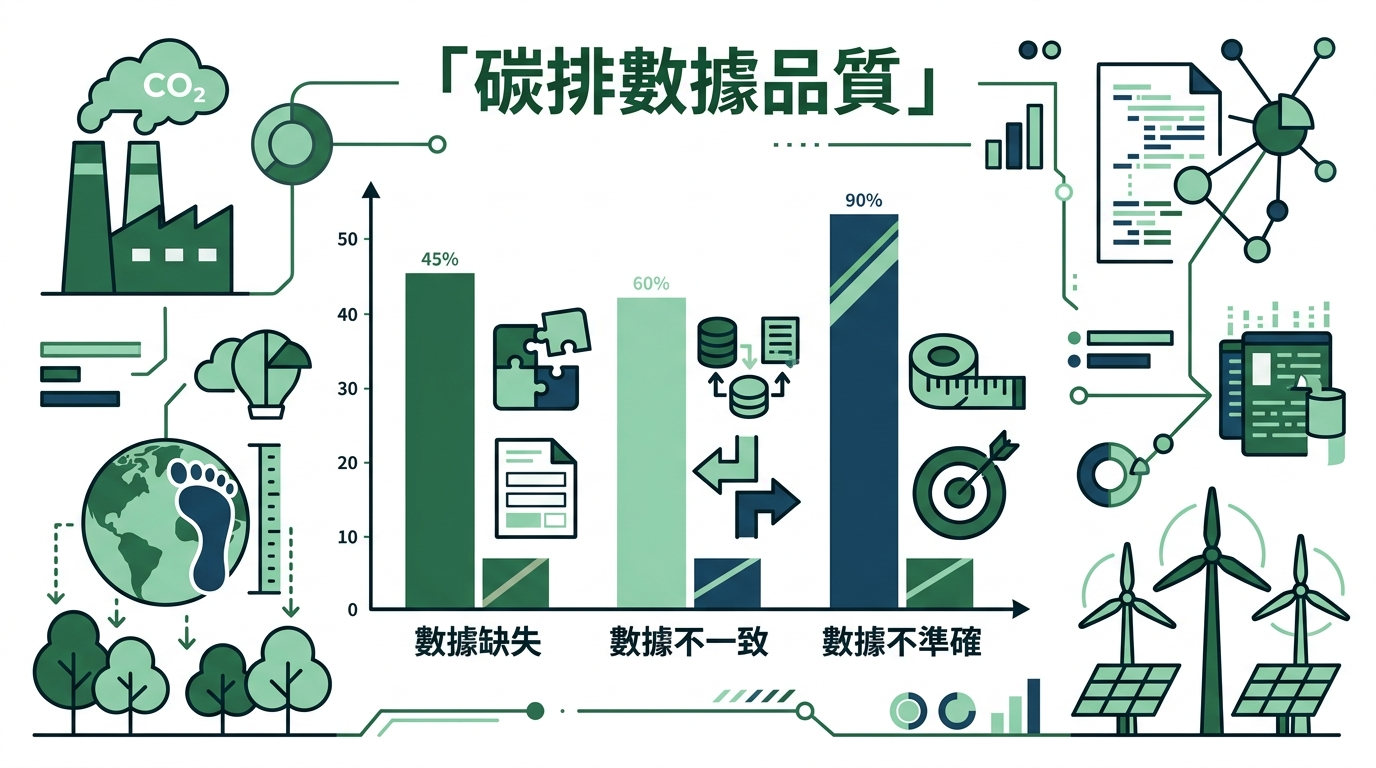
碳排數據品質
- 數據缺失
- 數據不一致
- 數據不準確
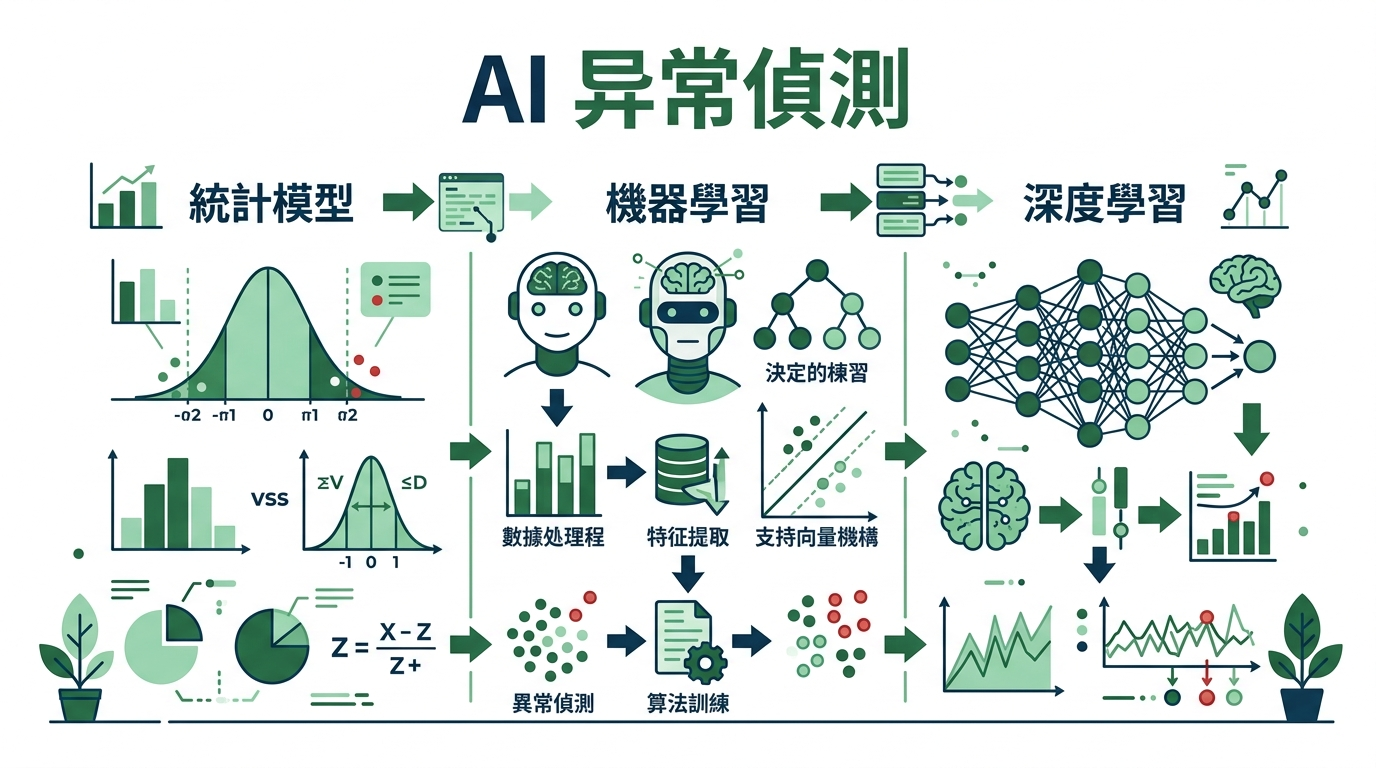
AI 异常偵測
- 統計模型
- 機器學習
- 深度學習
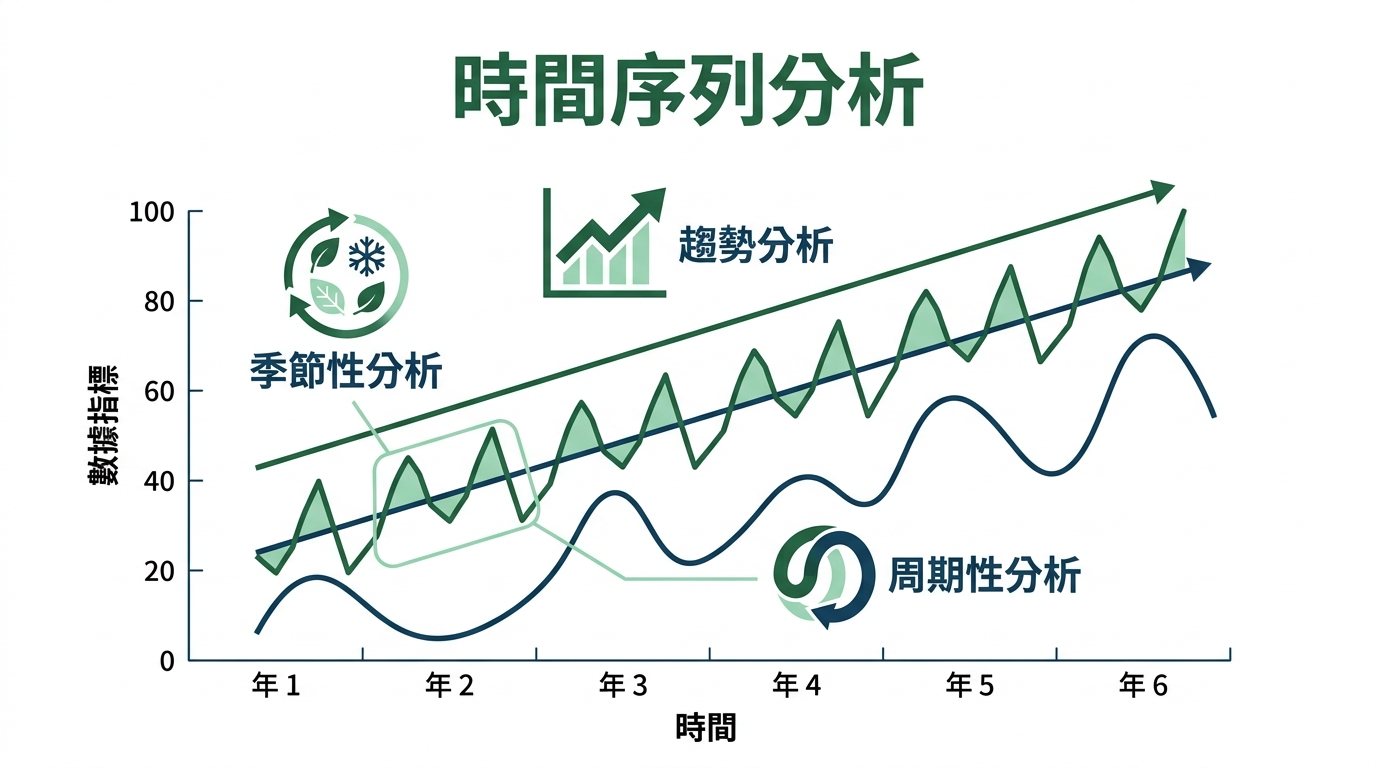
時間序列分析
- 趨勢分析
- 季節性分析
- 周期性分析
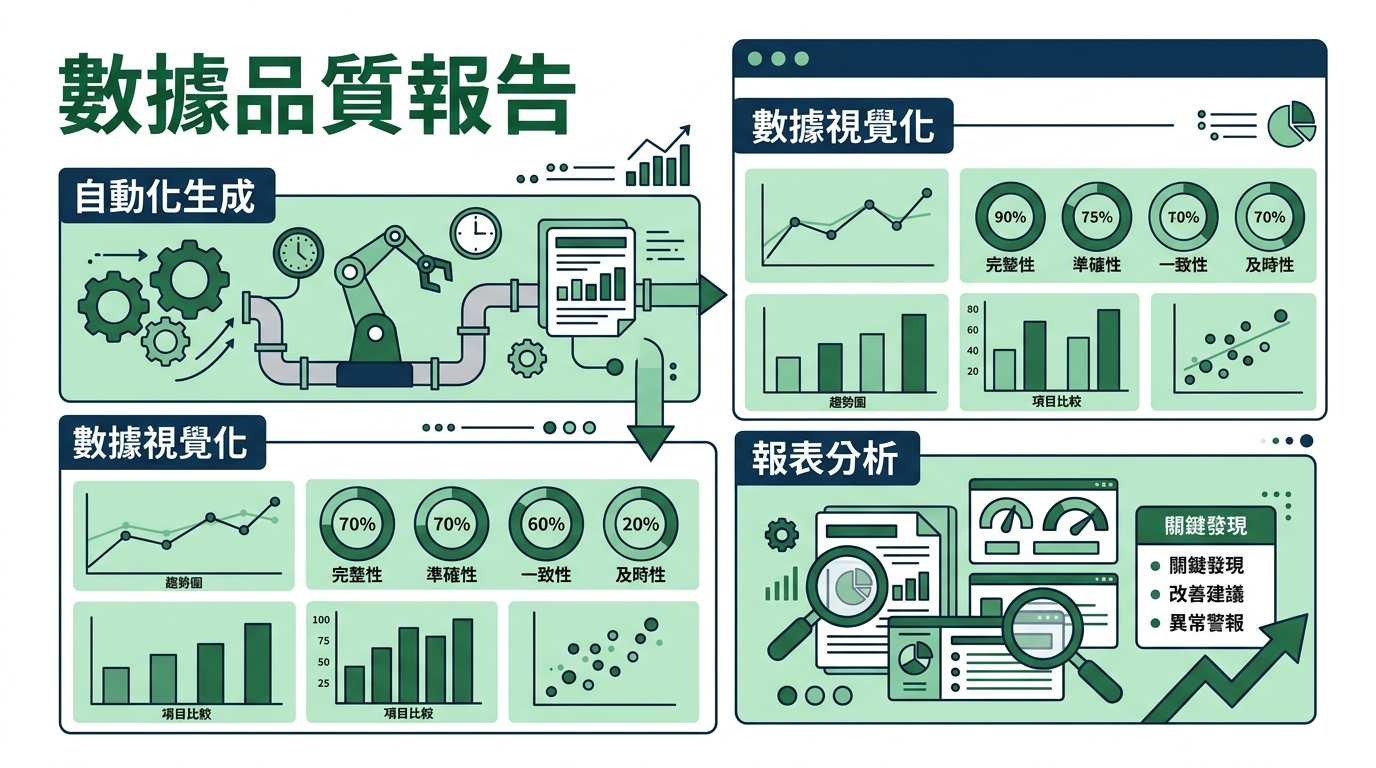
數據品質報告
- 自動化生成
- 數據視覺化
- 報表分析
研究報告
AI 碳排異常偵測與數據品質管理研究報告
在 2025 年作為台灣「排碳有價元年」的背景下,碳排數據已不再只是 ESG 報告中的裝飾品,而是直接與企業財務成本掛鉤的「綠色貨幣」。根據環境部公告,企業將於 2026 年根據 2025 年的實際排放量正式「繳交」碳費,這標誌著碳資產管理進入法制化階段。隨著相關盤查要求在產業鏈中深化,數據品質管理(Data Quality Management, DQM)成為企業合規的首要挑戰。本研究文件將深入探討如何運用 AI 技術,建立從異常偵測到自動化報告的完整數據治理體系。
碳排數據的常見品質問題類型
碳排數據的品質通常依據 ISO 14064-1 標準中的五大原則:相關性、完整性、一致性、準確性與透明度來衡量。然而,在實際操作中,企業往往面臨多樣化的數據品質缺口,這些問題若未經 AI 預篩處理,將導致查證成本大幅上升,甚至面臨合規風險。
數據遺失與斷層(Data Gaps) 這是最常見的問題,尤其發生在範疇二(能源利用)與範疇三(供應鏈)中。例如,某廠區因 IoT 感測器離線或電費單錄入延遲,導致特定月份出現「零排放」的虛假現象。若不進行偵測,計算出的年度碳強度將嚴重低估。
量綱錯誤與輸入異常(Unit Errors) 在多廠區、跨境營運的企業中,常因單位換算(如:公升與加侖、度與千瓦小時)失誤,導致數據出現 10 倍甚至 100 倍的偏離。這類人為疏失在傳統人工稽核中極難被即時發現。
活動數據與生產現況脫鉤(Operational Decoupling) 有時數據本身是正確的電錶讀數,但與生產產量不成比例。例如,生產線停工期間電力消耗卻未下降,這可能代表設備漏電或虛功補償異常。這種「正確但無效」的數據會誤導減碳策略的制定。
排放係數過時(Outdated Emission Factors) 台灣電力排放係數每年由能源署更新,若企業內部的管理系統未及時同步,或誤用不同年度的係數,將導致最終的 CO 2
e 計算結果出現系統性偏差。
AI 統計模型在異常偵測中的應用
為了處理上述複雜的品質問題,現代碳管理平台引入了多種 AI 統計模型,將異常偵測(Anomaly Detection)從被動查核轉為主動預警。
孤立森林(Isolation Forest)與聚類分析 AI 模型透過學習歷史排放行為,將數據對應到多維空間中。孤立森林演算法特別擅長偵測「疏離點」,即那些在特徵空間中容易被孤立的數據。
公式原理: 在特徵空間中,異常點通常具有較短的平均路徑長度 h(x)。異常得分 s(x,n) 定義為:
s(x,n)=2 − c(n) E(h(x))
當得分接近 1 時,該筆碳排數據被判定為高度可疑,系統將自動標記並要求經辦人核對原始憑證。
基於同儕組別(Peer Group)的橫向對比 AI 會根據設備類型(如:冰水主機、空壓機)或廠別進行分群。當某部設備的碳強度(單位產量的排放量)顯著高於同儕平均值時,系統會判定為「效率異常」或「數據錄入偏差」。這種方法能有效辨識出隱藏在正常波動範圍內的相對異常。
時間序列分析辨識碳排趨勢異常
碳排放通常具有強烈的季節性與週期性(Seasonality),單純的靜態閾值偵測容易產生大量誤報。因此,應用時間序列分析(Time Series Analysis)是提升偵測精度的關鍵。
長短期記憶網路(LSTM)的應用 對於具備時間關聯性的能源數據,AI 採用 LSTM 模型來預測「下一階段應有的排放範圍」。LSTM 能夠捕捉長期趨勢(如:產能逐年擴張)與短期波動(如:夏季空調負荷增加)。
趨勢轉折點偵測(Change Point Detection) 在本研究設定之警示指標中,當碳強度年度變化超過 30% 時,AI 會分析這是否屬於「結構性轉變」。
情境 A: 企業更換了高效能節能設備,趨勢向下轉折,AI 驗證相關資本支出後判定為「合規節能」。
情境 B: 數據突增但無相對應的產量提升,AI 判定為「異常偏離」。
透過分解時間序列為:
Y t
=S t
+T t
+R t
(其中 S t
為季節成分,T t
為趨勢成分,R t
為隨機殘差),AI 能夠精準鎖定殘差項過大的異常點,避免受季節因素干擾。
最新趨勢與新聞整合
根據 2025-2026 年的最新產業動態,AI 碳管理已從「選配」轉為「標配」:
環境部法規與 AI 轉型: 根據環境部碳費審議會之決議,一般費率初步建議為每公噸 300 元,若企業願意採取減量行動,可申請優惠費率 A(50 元/噸)或 B(125 元/噸)。企業為精準計算潛在成本並爭取優惠費率,積極導入 AI 系統自動化收集數據,確保申報數據的「可追溯性」,避免因錯誤數據導致法律風險。
資策會 2026 十大科技趨勢: 資策會於 2025 年底預測,「綠色 AI(Green AI)」將成為核心。AI 應用從單純的生成轉向「價值落地」,重點在於利用 AI 進行能源耗損與碳排的即時監控。
供應鏈數據揭露(待核實具體報告): 綠色和平於 2024-2025 年之相關研究中,多聚焦於 AI 算力基礎設施導致電力需求暴增之環境挑戰。目前台灣 AI 供應鏈正處於數據透明化之關鍵期,這促使大型代工廠要求供應商導入 AI 驅動的數據驗證模型,以確保在 2026 年接軌國際碳關稅(如歐盟 CBAM)時具備可靠數據。
台灣觀點:法規要求與企業實務
台灣企業在數據品質管理上,必須同時滿足國內法規與國際客戶的雙重審核。
具體法規背景
《氣候變遷因應法》與碳費收費辦法: 環境部規定年排放量達 2.5 萬公噸 CO 2
e 的電力業與製造業為首波強制盤查與徵收對象。目前強制盤查範疇(第一、二批)仍以製造業為主,服務業、運輸業與醫療院所多屬於金管會要求之永續報告規範,或屬於自願盤查範圍。
金管會「上市櫃公司永續發展路徑圖」: 要求企業必須揭露溫室氣體盤查資訊。若數據品質不佳導致財報更正,將影響信用評等。
企業案例:宇沛永續與智慧製造 台灣本土企業如宇沛永續已將 AI 異常偵測整合進智慧製造方案。他們透過 IIoT(工業物聯網)收集生產線即時數據,當 AI 偵測到某製程的碳排熱點異常升溫時,會自動聯動維護系統檢查設備磨損狀況。這種將「碳排監控」與「設備維護」結合的作法,是台灣電子代工業雙軸轉型(數位與綠色)的典範。
自動化數據品質報告的建立
高品質的數據最終需要轉化為可供決核的報告。自動化數據品質報告(Auto-DQR)應包含以下核心指標:
指標名稱 定義與 AI 作用 查證價值 數據完整性得分 AI 檢查所有排放源是否有對應的活動數據。 確保無漏報,降低查證缺失。 異常標註率 報告期內經 AI 標註並人工覆核的異常筆數。 展示內部控制與糾正機制。 變異係數 (CV) 分析排放強度隨時間的穩定性。 評估生產流程是否穩定受控。 係數透明度指標 檢查各排放源所引用的係數來源與年度。 確保合規性與國際接軌。 匯出到試算表
透過建立自動化報告,企業在面對第三方查證機構(如 SGS, BSI)進場時,可直接產出「數據品質履歷」,顯著縮短查證週期並降低查證費用。
結語與未來發展
AI 碳排異常偵測不只是技術問題,更是企業誠信與競爭力的展現。在 2026 年這個實際繳交碳費的轉折點,數據的「真實性」將決定企業在碳關稅時代的生存空間。