Podcast(中文)
簡報圖卡
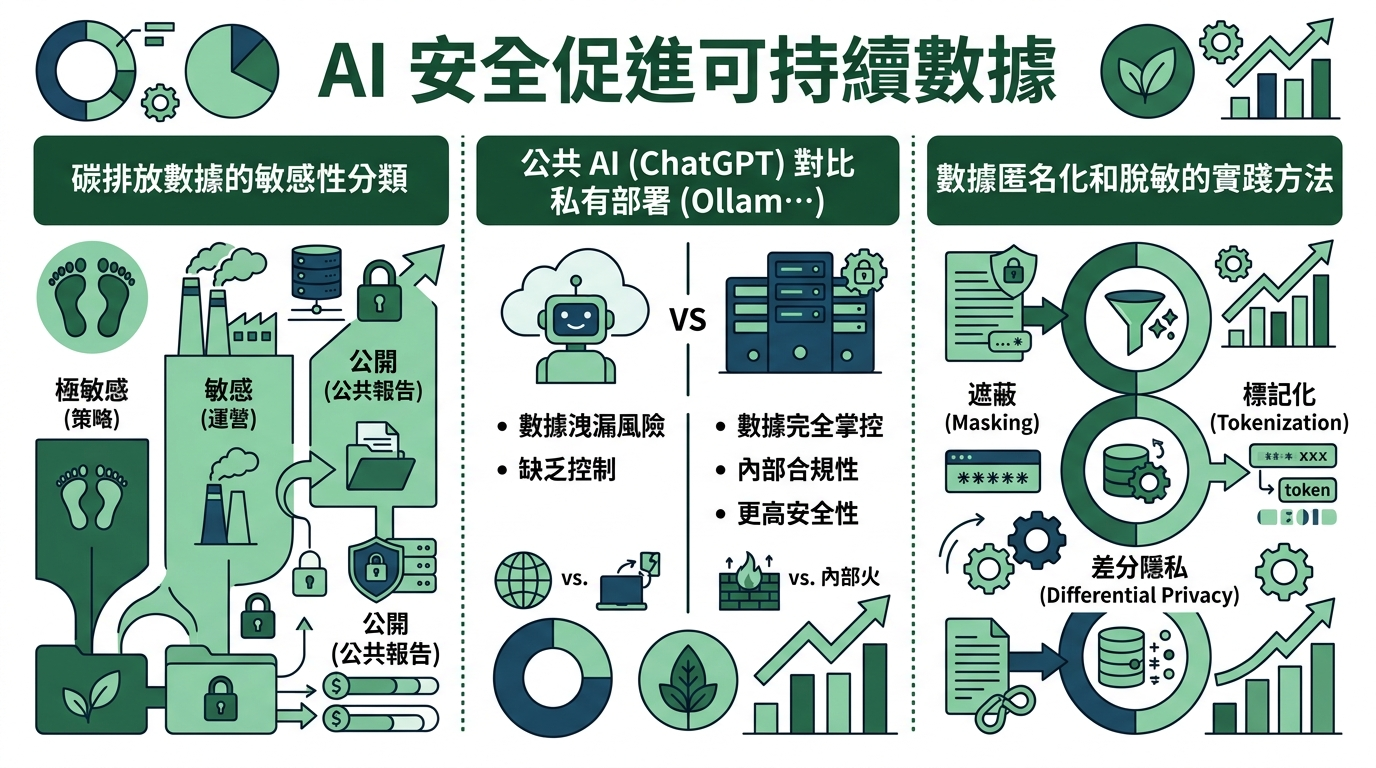
資料安全
- 碳排數據敏感度分級
- 公開AI資安風險
- 企業政策建議
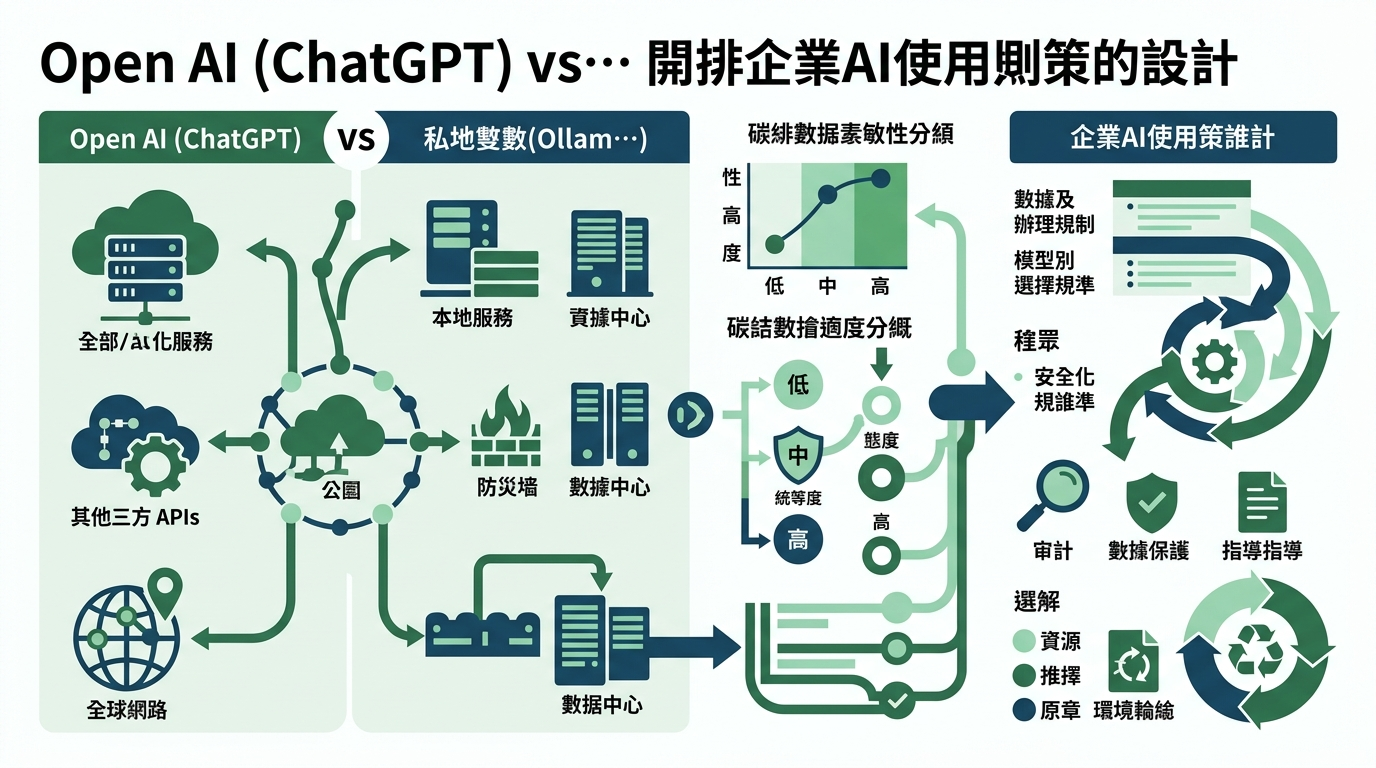
AI 資安比較
- 公開AI風險高
- 私有部署安全
- 資料控制重要
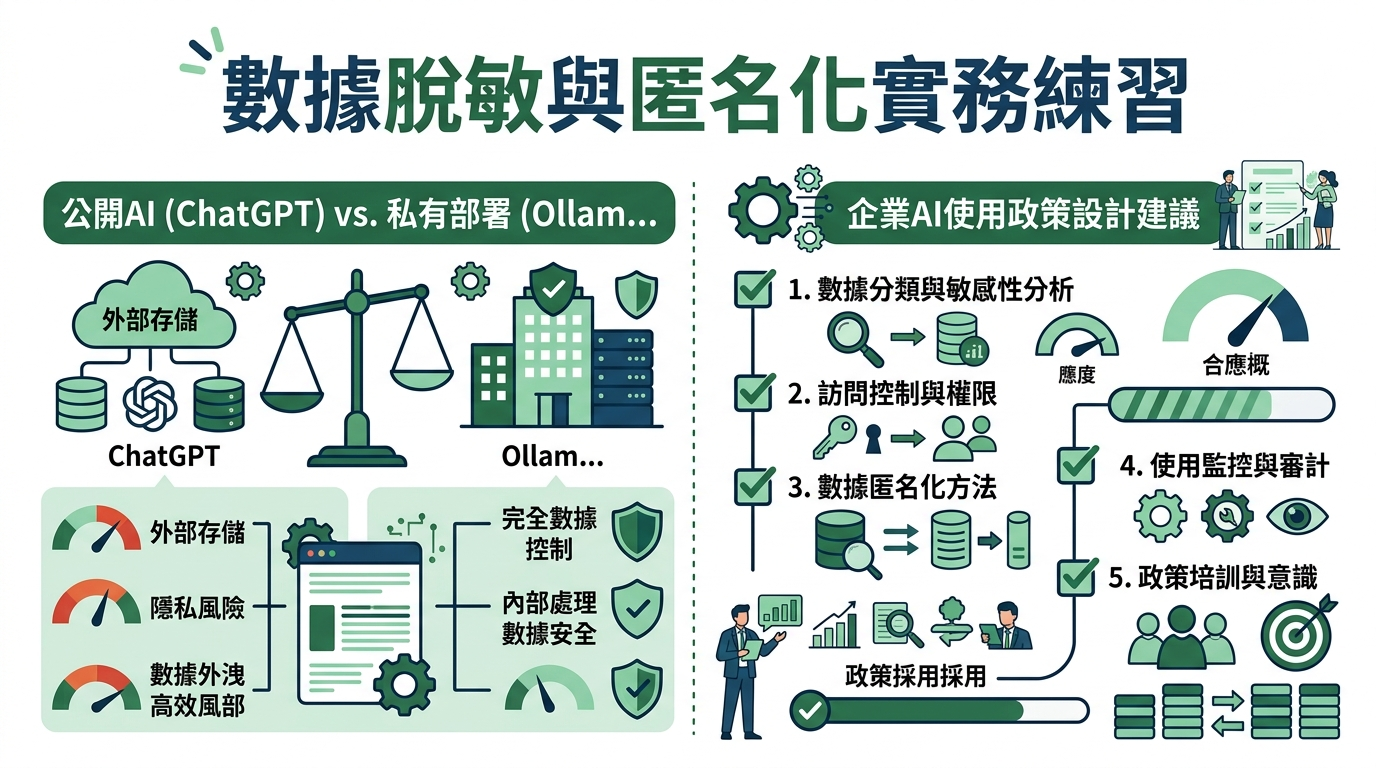
資料保護
- 資料脫敏實務
- 匿名化技術
- 安全性提升
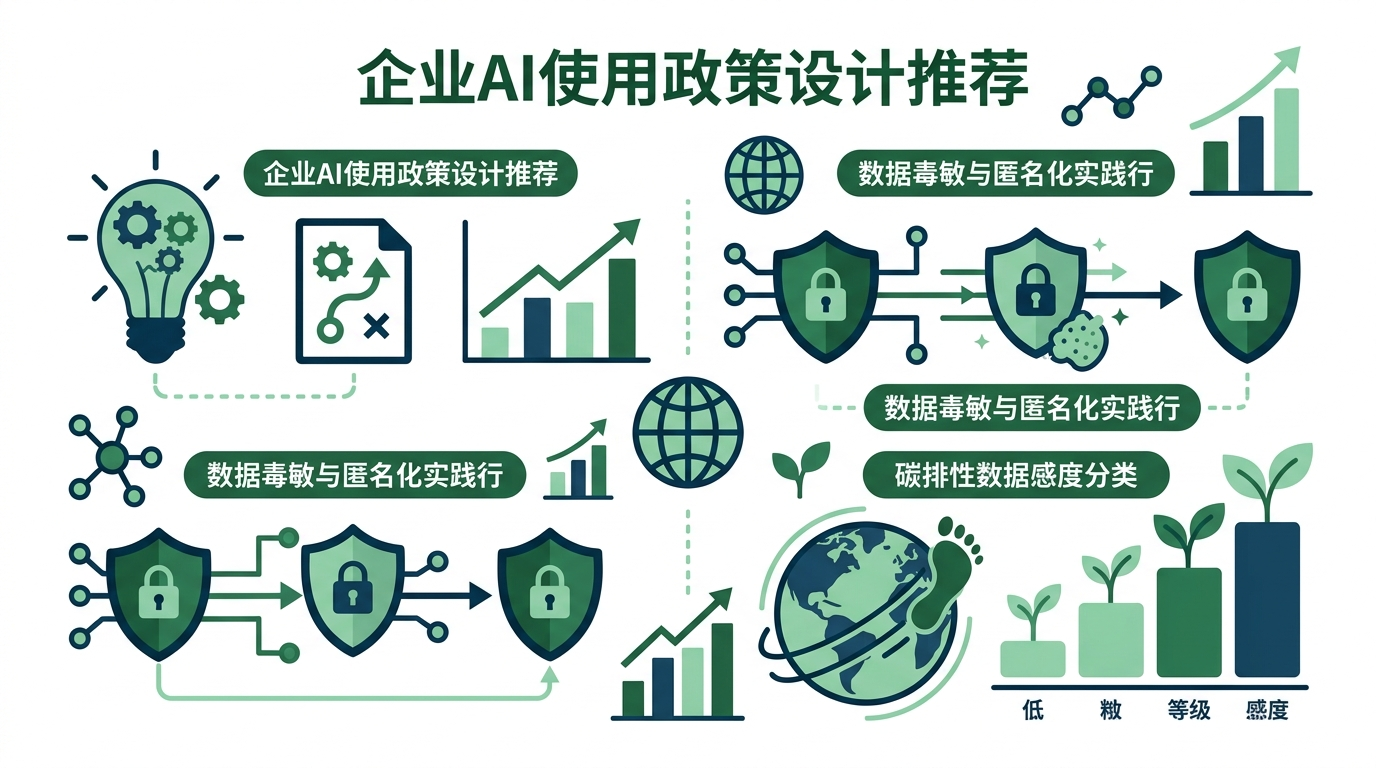
企業政策
- AI 使用政策建議
- 資料安全管理
- 員工教育重要
研究報告
這是一份針對「永續資料的 AI 安全」深度研究報告。本報告結合了 2026 年最新的法規趨勢、技術架構以及企業治理建議,旨在為企業在推動 ESG 數位轉型時,提供一份兼具安全性與效率的數據餵養指南。
永續資料的 AI 安全:哪些數據可以餵給 AI? 前言:當綠色轉型遇上 AI 浪潮
進入 2026 年,企業面臨的挑戰已不再是「是否要執行 ESG」,而是「如何利用 AI 加速 ESG」。然而,隨著《人工智慧基本法》的落實與數據主權意識的抬頭,一個核心矛盾浮現:為了讓 AI 給出精準的減碳建議,我們必須餵養數據;但數據一旦上傳,是否意味著企業的核心機密與供應鏈隱私將赤裸地暴露在公有雲端?
本報告將從數據分級、工具選擇、脫敏技術及政策設計四個維度,為您拆解永續數據進入 AI 模型的安全路徑。
一、 碳排數據的敏感度分級
在處理永續數據時,企業常犯的錯誤是「一刀切」——要麼全面封鎖 AI,要麼毫無防備地傾倒數據。事實上,並非所有碳排數據都具有相同的資安風險。我們建議將數據分為三個等級:
1.1 公開透明級(Green Zone)
這類數據主要包含已發布的永續報告書(ESG Report)、企業公開的承諾(如 RE100 宣告)以及政府法規文件。這些資訊本身就是為了溝通而存在,將其餵給 ChatGPT 等公開 AI 工具,能有效協助企業進行法規比對、摘要撰寫與同業標竿分析。
1.2 營運敏感級(Yellow Zone)
包含具體的範疇一(直接排放)與範疇二(能源間接排放)的原始數據,如電費單據、製程中的燃料消耗、冷媒填充紀錄等。這類數據雖然看似只是「數字」,但若被競爭對手取得並透過 AI 逆向工程分析,可能推導出企業的產能利用率、製程良率甚至訂單波動情況。
案例分析: 若一家半導體廠將其每月的精確用電與特殊氣體消耗數據餵給公開 AI,對手可輕易計算出該廠的單位產出能耗,進而推估其最新製程的成熟度。
1.3 策略機密級(Red Zone)
這涉及最複雜的範疇三(價值鏈排放),包含供應商的具體排放數據、產品碳足跡(PCF)的詳細物料清單(BOM)、物流路線規劃以及未來的減碳路徑財務預算。這些數據涉及供應鏈的商業關係與採購價格敏感性,屬於絕對禁止上傳至公開模型的核心資產。
二、 公開 AI(ChatGPT)vs. 私有部署(Ollama、AnythingLLM)
面對上述分級,企業需要建立「混合式 AI 架構」。2026 年的技術趨勢顯示,企業不再依賴單一模型,而是根據任務性質選擇不同的部署方式。
2.1 公開 AI:效率與博學的優勢
對於處理法規條文、翻譯國際準則(如 ISSB 或歐盟 CSRD)或撰寫對外的永續新聞稿,ChatGPT (OpenAI)、Claude (Anthropic) 或 Gemini (Google) 是首選。它們擁有最強大的跨領域知識,能理解複雜的法律語境。然而,即使是企業版(Enterprise Edition),雖然條款承諾數據不被用於訓練,但數據仍儲存在服務商的伺服器上,存在「合規性」與「信任度」的天然鴻溝。
2.2 私有部署:主權與隱私的終極防線
針對敏感的「黃區」與「紅區」數據,2026 年企業的主流選擇是利用 Ollama 或 vLLM 配合 AnythingLLM 或 Dify 建立本地知識庫(RAG, Retrieval-Augmented Generation)。
Ollama: 讓企業能在內網伺服器(甚至是一台配備高效能 GPU 的筆電)上運行 Llama 3 或 Mistral 等開源大模型。
AnythingLLM: 提供了一個易用的介面,讓員工能將機密的 Excel 碳排報表上傳至「本地向量數據庫」,AI 在回答問題時僅檢索本地文件,數據完全不離開企業防火牆。
三、 資料脫敏與匿名化的實務做法
即使使用私有部署,為了落實「最小化數據暴露」原則,企業在將永續數據餵給 AI 前,必須進行脫敏處理。這不僅是資安要求,更是符合《人工智慧基本法》中對於數據透明度與正確性的要求。
3.1 關鍵技術:掩碼與擾動
標識符替換(Pseudonymization): 將供應商名稱「台積電」替換為「Supplier_A」,將特定工廠地址替換為區域代碼。這樣 AI 仍能計算排放總量,但無法將結果關聯到特定實體。
數值擾動(Differential Privacy): 在不影響統計結果的前提下,對微觀數據加入微小的雜訊。例如,將某月的排放量 1234.56 噸改為 1234.6 噸。
聚合處理: 不要餵養單日的電費數據,而是餵養週或月的平均值,防止 AI 透過用電高峰推測出生產班表。
3.2 自動化脫敏流程
企業應建立一套「AI 數據預處理管道」。當員工欲將一份 Excel 報表餵給 AI 進行分析時,系統自動掃描 PII(個人識別資訊)與敏感商業標籤,強制進行去識別化後再進入模型。這在 2026 年被稱為「代理式數據治理」,是確保 ESG 數據合規性的關鍵技術。
Data Privacy Index= ∑(Total Sensitive Fields) ∑(De-identified Fields)
×100% 四、 企業 AI 使用政策的設計建議
工具與技術到位後,最脆弱的環節往往是「人」。根據 2026 年的資安趨勢調查,高達 70% 的 CEO 表達了對核心機密外洩的擔憂,雖然其中僅有 30% 處於「極度焦慮」,但整體憂慮比例反映出數據治理已成為最高管理階層的首要課題。
4.1 建立「紅綠燈決策框架」
企業應提供員工一份簡單的對照表:
綠燈(自由使用): 查詢國際標準、修飾公開報告文案、翻譯非機密減碳技術文件。
黃燈(受限使用): 需使用公司指定的企業版 AI 或私有部署工具,處理內部初步統計數據。
紅燈(嚴格禁止): 未經去識別化的供應商名單、未來三年的碳中和預算編列、尚未公開的重大裁罰資訊。
4.2 設立 AI 倫理與資安委員會
這個委員會應由永續長(CSO)、資訊長(CIO)與法務長組成。其職責是審核哪些 AI 模型被允許接入公司數據,並定期審計 AI 產出的建議是否存在「漂綠」(Greenwashing)風險。
五、 最新趨勢與新聞整合
在撰寫本報告時,我們整合了 2025-2026 年的三則關鍵新聞,這些事件直接形塑了目前的 AI 安全景觀:
《人工智慧基本法》三讀通過 (2026/01/13): 根據立法院公報,此法案於 2026 年第一會期初完成三讀,並於 2 月正式公告實施。法律確立了「風險分級管理」,對於涉及環境保護等關鍵基礎設施的 AI 應用,政府要求數據餵養必須經過驗證,確保來源透明且不可竄改,否則將面臨高額罰款。
執行長的資安憂慮 (2026/02/16): 根據 2026 年 PwC 全球 CEO 調查,超過 70% 的 CEO 擔心核心機密外洩。這股焦慮推動了企業從單純「嘗試 AI」轉向「建置數據防火牆」。在 ESG 領域,企業開始要求供應商在提供範疇三數據時,必須使用具備加密協定的 AI 介面。
台灣大與諾基亞的 ESG 2.0 合作 (2026/03/03): 此項合作是在巴塞隆納 MWC 2026 期間正式簽署並發布。雙方針對 AI 節能與基地台韌性展開深度合作,透過 AI 即時分析訊號並調節能耗,同時強化「系統韌性」,確保 AI 模型在接收外部數據時具備防禦惡意攻擊的能力,避免通訊中斷。
六、 台灣觀點:法規、挑戰與企業案例
台灣作為全球供應鏈的核心,在永續數據的 AI 應用上具有獨特地位。
6.1 法規環境:從指引走向強制
除了上述的《人工智慧基本法》,金管會於 2024/06/20 首次發布 並於 2025/11/12 更新版本 的《金融業運用 AI 指引》中,明確規定涉及永續金融評分(ESG Scoring)的 AI 模型必須強化透明度要求與「可解釋性」。這直接影響了上市櫃公司,因為其碳排數據的真實性將聯動到銀行的綠色融資條件。
6.2 企業案例:中堅企業的私有化實踐
台灣某電子代工大廠(EMS)為了應對歐盟 CBAM(碳邊境調整機制),開發了內部的「ESG AI 助手」。該系統部署在公司私有雲,整合了 Ollama 框架,讓員工能上傳各廠區的物料清單(BOM)進行本地分析。
成功關鍵: 該公司明確規定,所有涉及客戶產品結構的敏感數據嚴禁離開內網。這讓他們在符合歐盟嚴格審查的同時,守住了全球客戶的商業機密。
總結與建議
永續數據與 AI 的結合是不可逆的趨勢,但「安全」是這輛高速列車的剎車系統。企業不應因為恐懼而拒絕 AI,而應透過數據分級、私有化部署、自動化脫敏與嚴格的政策管理,建立起一套防禦體系。
在 2026 年的今天,數據的安全性即是企業的競爭力。當您能夠比對手更安全地利用 AI 優化減碳路徑時,您不僅是在守護商業機密,更是在數位轉型的賽道上取得領先。
下一步您可以做的是…
如果您正準備為公司建立 AI 使用規範,您希望我為您草擬一份針對「ESG 部門」的《AI 工具使用守則》初稿嗎? 我可以根據上述的紅綠燈框架,為不同職位設定具體的權限建議。